Finetune LLM cho dược và thông tin thuốc: tra cứu, nhãn, nhà thuốc
01/10/2026
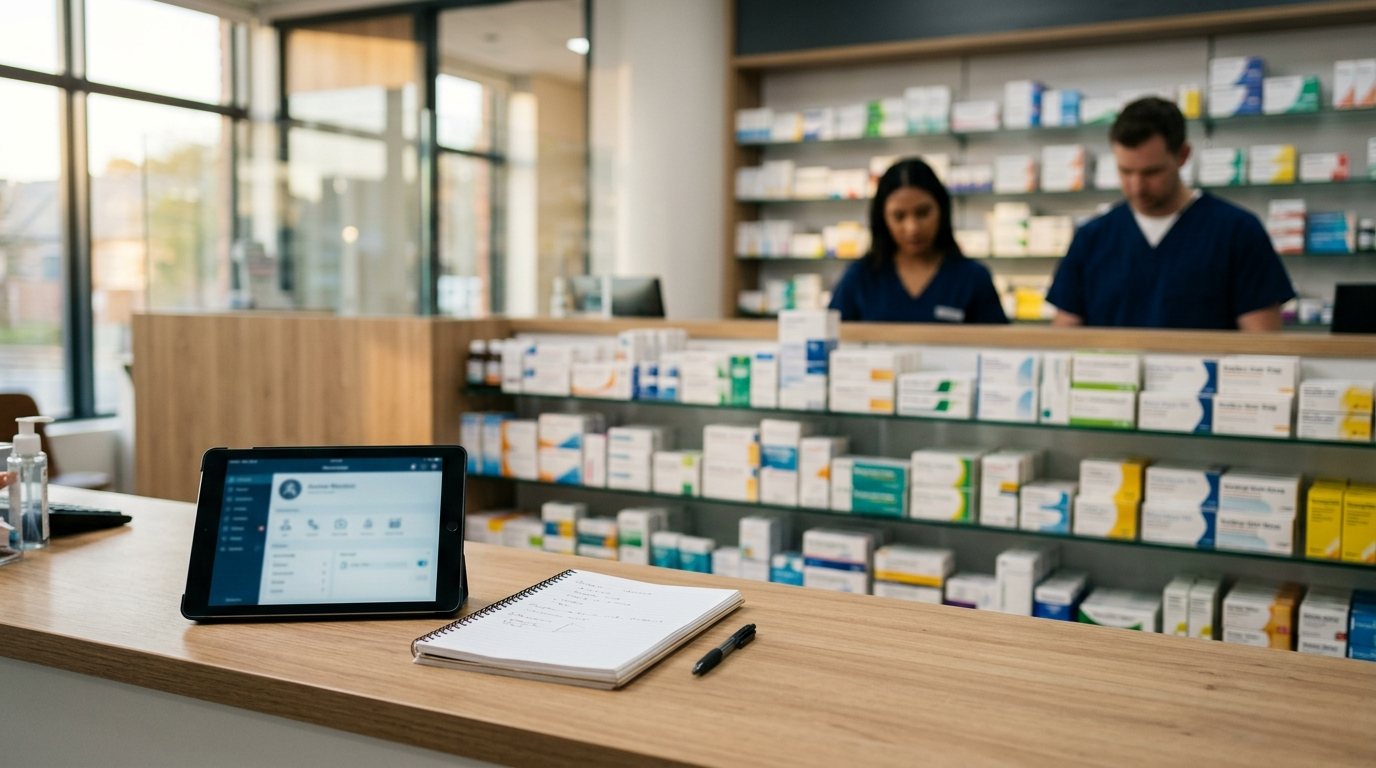
Một chiều thứ Bảy ở quầy thuốc đông khách, dược sĩ vừa tư vấn cho người này vừa bị người kia hỏi chen vào: thuốc này có hoạt chất gì, hộp kia khác hộp này ở chỗ nào, tờ hướng dẫn in chữ nhỏ quá đọc không nổi. Đa số câu hỏi là tra cứu, và tra cứu là việc mà máy làm được. Đó là lý do finetune LLM cho lĩnh vực dược đang được nhiều đội quan tâm, và cũng là lý do cần bàn kỹ chuyện nó nên và không nên làm gì.
Chúng tôi ở AIVISION làm training và finetune LLM tiếng Việt cho các lĩnh vực cụ thể, trong đó có dược và thông tin thuốc. Bài này là cách nhìn của người làm sản phẩm, không phải lời quảng cáo.
Vì sao model tổng quát chưa đủ cho thông tin thuốc
Hỏi một mô hình tổng quát về thuốc, bạn sẽ nhận được câu trả lời nghe rất ra dáng. Vấn đề nằm ở chữ nghe. Thông tin thuốc là loại dữ liệu mà sai một chi tiết nhỏ cũng khác nghĩa: tên thương mại và tên hoạt chất, dạng bào chế, quy cách đóng gói, các mục trong tờ hướng dẫn sử dụng. Mô hình tổng quát được huấn luyện trên lượng chữ khổng lồ từ internet, trong đó thông tin thuốc bằng tiếng Việt chiếm một phần nhỏ và chất lượng không đồng đều.
Kết quả quen thuộc là mô hình trộn lẫn hai sản phẩm có tên gần giống nhau, hoặc bịa ra một mục không có trong tài liệu gốc. Không phải vì nó ác ý, mà vì nó được tối ưu để viết câu trơn tru, không phải để dừng lại khi không chắc.
Finetune để làm gì, và với dữ liệu nào
Finetune là huấn luyện tiếp một mô hình nền bằng dữ liệu của lĩnh vực hẹp, để nó quen với cách dùng chữ, cấu trúc tài liệu và kiểu câu hỏi của lĩnh vực đó. Với dược, ba nhóm việc thường được nhắc đến.
Tra cứu hoạt chất và thành phần
Người dùng hỏi một sản phẩm chứa thành phần gì, hoặc một hoạt chất xuất hiện trong những sản phẩm nào trong danh mục của nhà thuốc. Đây là bài toán ánh xạ giữa tên gọi, và mô hình cần hiểu cả tên thương mại lẫn tên gốc, cả cách viết có dấu lẫn không dấu mà khách hàng hay gõ.
Đọc và tóm tắt nhãn, tờ hướng dẫn
Biến một tờ hướng dẫn dài thành bản tóm tắt dễ đọc, đúng thứ tự mục, và giữ nguyên nội dung của tài liệu gốc. Mô hình chỉ trình bày lại những gì tài liệu viết, không thêm khuyến cáo của riêng nó.
Hỗ trợ nhân viên nhà thuốc
Tìm nhanh trong danh mục, nhắc quy trình nội bộ, soạn nháp nội dung trả lời để dược sĩ chỉnh. Người đứng quầy được rảnh tay hơn, quyết định vẫn là của họ.
Dữ liệu huấn luyện nên đến từ nguồn có thẩm quyền và có giấy phép sử dụng rõ ràng: tài liệu thuốc đã được cơ quan quản lý chấp thuận, danh mục sản phẩm của chính đơn vị, quy trình nội bộ. Dữ liệu càng sạch thì càng đỡ phải sửa lỗi về sau. Điều chúng tôi tránh là trộn dữ liệu không rõ nguồn gốc, vì một câu sai trong tập huấn luyện có thể trở thành một câu sai được nói ra với giọng chắc chắn.
Ranh giới cần giữ chặt
Có những việc mô hình không làm, và đó là quyết định thiết kế chứ không phải khiếm khuyết cần khắc phục.
- Không tư vấn liều dùng cho từng người.
- Không gợi ý thuốc để điều trị một triệu chứng hay bệnh lý cụ thể.
- Không thay dược sĩ trong việc đánh giá tương tác, chống chỉ định hay tình trạng của người dùng.
- Khi người hỏi mô tả triệu chứng, hệ thống hướng họ đến người có chuyên môn.
Thông tin thuốc khác với lời khuyên về thuốc. Cái đầu là tra cứu tài liệu: sản phẩm này đóng gói thế nào, tờ hướng dẫn ghi mục nào. Cái sau cần biết người dùng là ai, đang dùng gì, mắc gì, và đó là việc của người được đào tạo. Chúng tôi coi ranh giới này là điều kiện để sản phẩm tồn tại, không phải một dòng miễn trừ in nhỏ ở cuối trang.
Truy hồi tài liệu hay nhồi vào trọng số
Một quyết định kỹ thuật hay bị hiểu nhầm: có nên nhồi toàn bộ kiến thức thuốc vào mô hình bằng finetune hay không. Theo kinh nghiệm của nhiều đội, không nên. Danh mục thuốc thay đổi liên tục, sản phẩm mới ra, sản phẩm cũ bị thu hồi, tờ hướng dẫn được cập nhật. Nếu kiến thức nằm trong trọng số, mỗi lần thay đổi lại phải huấn luyện lại, và bạn không biết mô hình đã quên hay chưa.
Cách chia việc hợp lý hơn: finetune để mô hình giỏi ngôn ngữ của lĩnh vực, hiểu tên gọi, viết tắt, văn phong của tài liệu dược; còn nội dung cụ thể thì lấy từ kho tài liệu được cập nhật riêng, mô hình đọc rồi trả lời kèm trích dẫn. Khi tài liệu đổi, chỉ cần cập nhật kho. Và khi không tìm thấy gì, hệ thống nói là không tìm thấy, thay vì ứng biến.
Nói về năng lực một cách thành thật
AIVISION huấn luyện mô hình trên cluster 24 GPU NVIDIA H200 và 8 GPU NVIDIA B300, đã phát hành LLM L1.0 cho tiếng Việt, và nhận làm finetune cho các lĩnh vực như y tế và dược. Phần hạ tầng cho phép chúng tôi thử nhiều cấu hình huấn luyện. Nhưng chất lượng trên bài toán thuốc của một nhà thuốc cụ thể thì chỉ biết được sau khi đo, trên chính danh mục và những câu hỏi mà khách của họ hay hỏi. Vì vậy quy trình mà chúng tôi theo đuổi bắt đầu bằng bộ câu hỏi kiểm tra do dược sĩ của đơn vị đó soạn, chứ không phải bằng một con số đẹp rút từ nơi khác.
Có thể bạn sẽ hỏi vì sao không để dược sĩ tự soạn bộ kiểm tra. Thật ra chính là họ làm. Người hiểu nhà thuốc nhất là người đứng quầy, và những câu hỏi khó thật sự thường chỉ họ mới nghĩ ra: khách đọc sai tên thuốc theo kiểu địa phương, viết tắt theo thói quen, hỏi nửa câu rồi bỏ lửng.
Những gì đáng thử trước
Nếu bạn điều hành một nhà thuốc hoặc một chuỗi nhỏ và đang cân nhắc, tôi khuyên bắt đầu ở phía nhân viên, chưa phải phía khách hàng. Cho một công cụ nội bộ tra cứu danh mục và tờ hướng dẫn, để vài dược sĩ dùng một tháng, ghi lại chỗ sai. Sau đó mới tính đến chuyện đặt nó trước mặt người mua. Cách này chậm hơn một chút, nhưng nó cho bạn bằng chứng thật về việc công cụ đang làm đúng hay sai, và dược sĩ không bị ép tin vào thứ họ chưa kiểm chứng.
Cuối cùng, công nghệ này có ích khi nó làm việc tra cứu nhanh hơn và để người có chuyên môn dành sức cho phần chỉ họ làm được. Nếu nó bắt đầu giả vờ làm thay phần đó, nó đã đi quá xa.