Cluster 24 GPU H200 dùng để huấn luyện LLM như thế nào
01/10/2026
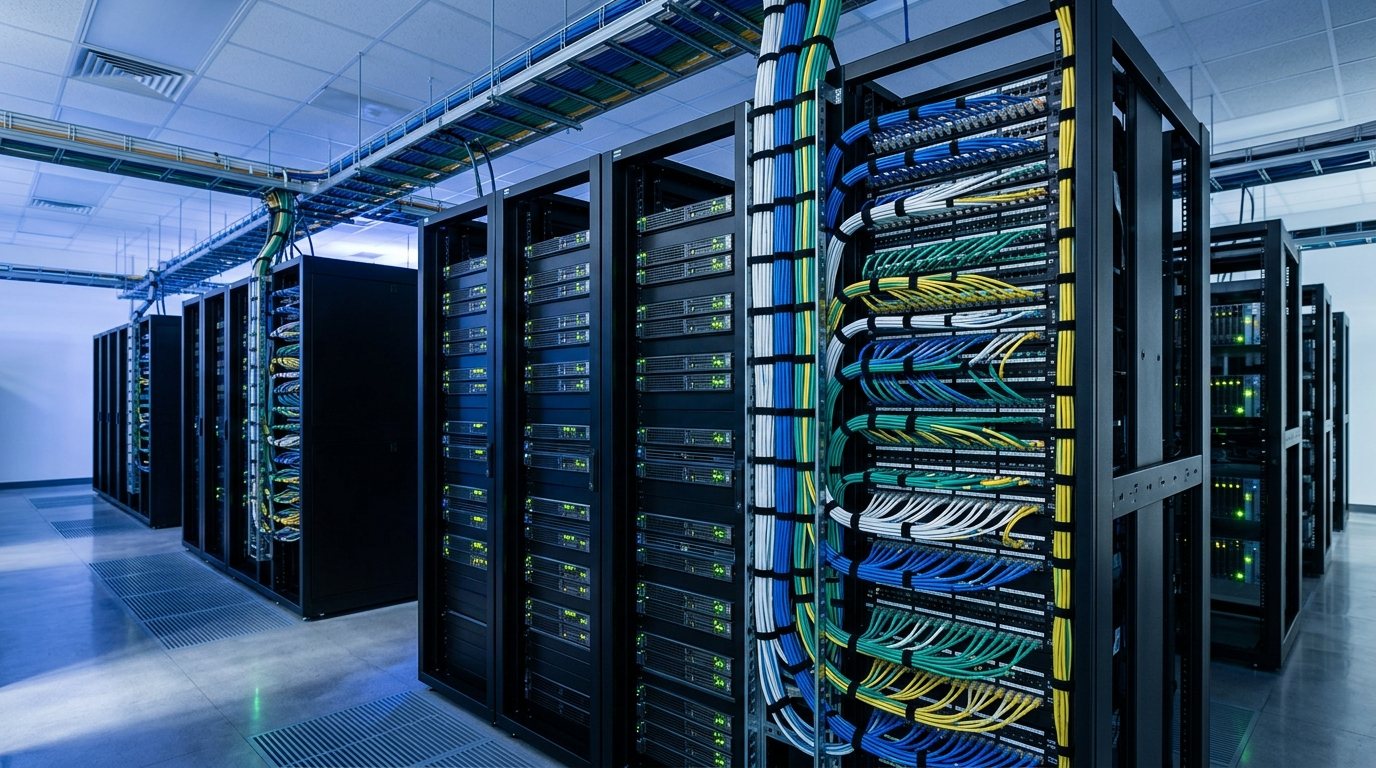
Hãy hình dung bạn phải chép tay một thư viện lớn trong một đêm. Một người chép thì không bao giờ kịp, nên bạn gọi thêm người, chia mỗi người vài kệ sách. Nhưng chia xong lại phát sinh chuyện mới: ai giữ bản gốc, ai kiểm tra lỗi, mọi người trao đổi với nhau bằng cách nào mà không mất cả buổi. Huấn luyện một mô hình ngôn ngữ lớn trên cluster 24 GPU H200 của AIVISION giống như vậy, chỉ khác là những người chép là các con chip và trang sách là hàng tỷ con số.
GPU H200 là gì, không cần thuật ngữ
H200 là GPU của NVIDIA thiết kế cho tính toán AI ở quy mô lớn. Hai thông số công khai đáng nhớ: mỗi chiếc có 141GB bộ nhớ HBM3e, và băng thông bộ nhớ khoảng 4,8TB/s. Bạn có thể nghĩ bộ nhớ là cái bàn làm việc, băng thông là độ rộng của lối đi để mang tài liệu lên bàn. Bàn càng rộng thì càng bày được nhiều thứ cùng lúc, lối đi càng rộng thì người làm càng ít phải đứng chờ.
Với LLM, việc đứng chờ là kẻ thù chính. Phần lớn thời gian của một con chip khi huấn luyện không phải để tính toán, mà để chờ dữ liệu từ bộ nhớ chạy tới. Đó là lý do băng thông quan trọng gần như ngang với sức mạnh tính toán thuần.
Cộng lại, 24 GPU với 141GB mỗi chiếc cho khoảng 3,3TB bộ nhớ GPU toàn cụm. Con số này là phép nhân từ thông số công khai, không phải số liệu đo của riêng chúng tôi, và nó cũng chưa nói lên mô hình lớn cỡ nào chạy được, vì bộ nhớ còn phải chứa nhiều thứ khác ngoài bản thân mô hình.
Vì sao một GPU không đủ
Khi huấn luyện, bộ nhớ không chỉ chứa các trọng số của mô hình. Nó còn chứa kết quả trung gian của mỗi lượt tính, gradient để cập nhật mô hình, và trạng thái của bộ tối ưu hóa. Cộng tất cả lại, nhu cầu bộ nhớ lớn hơn kích thước mô hình nhiều lần. Một GPU mạnh đến đâu cũng sớm chạm trần.
Giải pháp là chia việc. Có vài cách chia, và kỹ sư thường phối hợp chúng:
- Chia dữ liệu: mỗi GPU giữ một bản mô hình và xử lý một lô dữ liệu khác nhau, rồi cả nhóm cộng gộp kết quả.
- Chia mô hình: tách các lớp hoặc tách từng phép tính lớn ra nhiều GPU, khi một GPU không chứa nổi cả mô hình.
- Chia trạng thái huấn luyện: rải gradient và trạng thái tối ưu hóa ra nhiều máy để mỗi máy nhẹ gánh hơn.
Tất cả các cách trên đều có chung một cái giá: các GPU phải nói chuyện với nhau liên tục. Mạng kết nối giữa chúng vì thế quan trọng không kém bản thân chip. Một cluster có GPU xịn mà mạng chậm giống như đội chép sách giỏi nhưng chỉ liên lạc bằng thư tay.
Một ngày chạy training trông ra sao
Nói thật, phần lớn thời gian của kỹ sư không phải là nhìn đồ thị loss giảm đẹp. Một lần chạy dài thường kể một câu chuyện lộn xộn hơn nhiều. Có hôm một node treo vì lỗi nhỏ, cả job dừng và phải nạp lại từ checkpoint gần nhất. Có hôm loss bỗng nhảy vọt, và ta mất nửa buổi tìm xem do một lô dữ liệu bẩn hay do tốc độ học đặt quá cao.
Vì vậy checkpoint, tức là lưu trạng thái định kỳ, là thói quen sống còn. Lưu thường xuyên thì tốn thời gian ghi đĩa, lưu thưa thì khi hỏng mất nhiều công. Đây là một đánh đổi điển hình, và không có đáp án đúng chung cho mọi cụm. Mỗi đội phải tự tìm điểm cân bằng cho hệ thống của mình.
Một chuyện khác ít được nhắc: chi phí vận hành. Cụm 24 GPU tiêu thụ điện đáng kể và tỏa nhiệt nhiều, kéo theo bài toán làm mát, nguồn điện dự phòng, giám sát. Chúng tôi không đi sâu số liệu ở đây, nhưng ai nghĩ sở hữu GPU chỉ là mua xong rồi bật lên thì nên đi hỏi người vận hành phòng máy.
H200 phục vụ việc gì tại AIVISION
Cụm H200 là phần nặng đô của quy trình huấn luyện và finetune LLM tiếng Việt. Các công đoạn như huấn luyện tiếp trên dữ liệu tiếng Việt, finetune cho từng lĩnh vực như healthcare hay dược, và chạy lại thí nghiệm khi đổi cách xử lý dữ liệu đều cần nhiều giờ GPU liên tục.
Chúng tôi không nêu ở đây mô hình nào được huấn luyện bao lâu, bao nhiêu token, vì đó là thông tin chưa công bố. Điều có thể nói chung là: với bài toán finetune LLM, lợi thế của việc có cluster riêng là tính chủ động. Khi đội dữ liệu làm sạch xong một mảng tài liệu y tế vào buổi chiều, tối đó đã có thể chạy thử, sáng hôm sau xem kết quả. Cái vòng phản hồi ngắn đó đáng giá hơn người ta tưởng.
Lưu ý quan trọng về y tế: dù finetune cho healthcare và dược, mục tiêu là hỗ trợ thông tin và hành chính. Mô hình không chẩn đoán, không kê đơn, không khuyên liều dùng, và chuyên môn y khoa luôn quyết định cuối cùng.
Những đánh đổi nên biết
Cluster lớn không phải lúc nào cũng là câu trả lời. Với các thí nghiệm nhỏ, việc điều phối 24 GPU còn tốn công hơn chạy trên vài chiếc. Đôi khi một ý tưởng nên được kiểm nghiệm trên quy mô nhỏ trước, và chỉ những ý tưởng sống sót mới được đưa lên cụm lớn.
Ngoài ra, cụm H200 và cụm B300 của AIVISION được dùng cho những phần việc khác nhau. B300 với khoảng 288GB HBM3e mỗi GPU có cách dùng riêng, mà chúng tôi trình bày ở bài về Blackwell Ultra. Chia việc đúng giữa hai cụm cũng là một phần của nghề.
Nếu bạn đang cân nhắc tự xây hạ tầng hay thuê ngoài cho dự án AI Việt Nam của mình, lời khuyên thực dụng nhất của chúng tôi là: hãy đo nhu cầu thật trước. Bao nhiêu giờ GPU mỗi tháng, chạy đều hay thất thường, có đội vận hành hay không. Ba câu hỏi này quyết định phần lớn, và chúng không liên quan gì đến việc con chip nào đang được quảng cáo nhiều nhất.
Bạn có thể đọc thêm về cách chúng tôi làm việc tại AIVISION.